「AIエージェントは自律的に動く」と聞いても、内部で何が起きているのかを説明できず困っていないでしょうか。
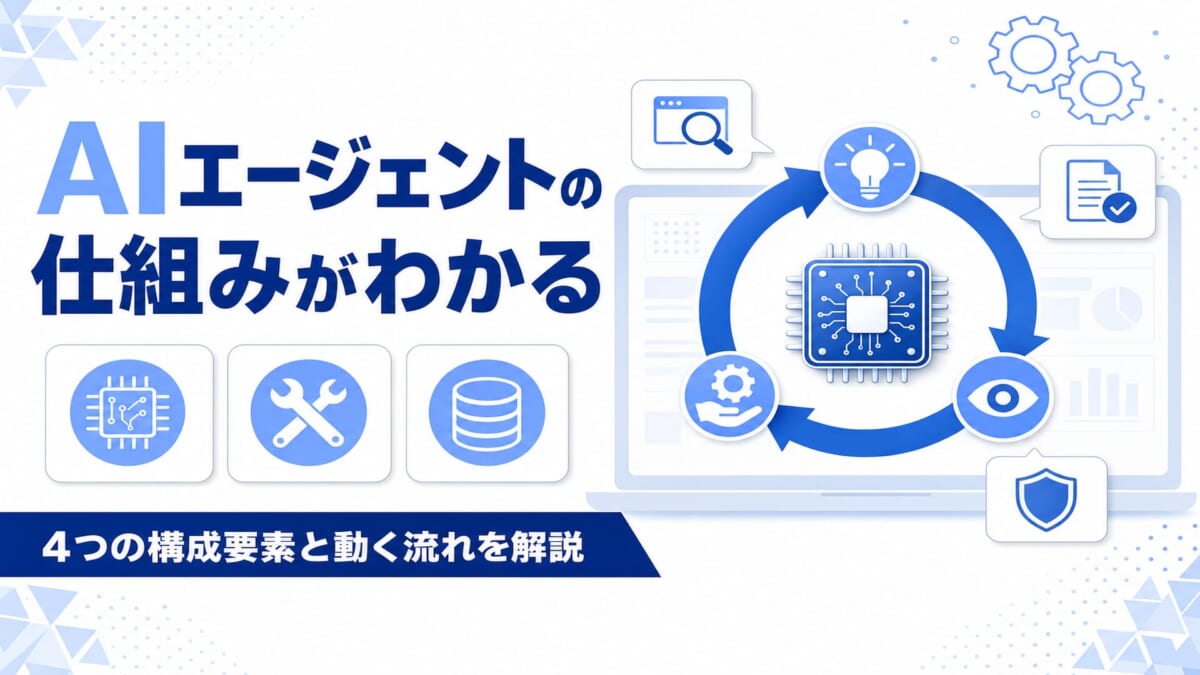
AIエージェントの仕組みは、LLMが頭脳となり、ツールとメモリを使って「考える・行動する・確かめる」を繰り返す構造です。
仕組みを知らないまま導入すると、任せる範囲や権限を誤り、誤操作や情報漏えいを招きます。反対に仕組みを理解していれば、ベンダーの提案が妥当かを自分で見極められます。
本記事では、AIエージェントを構成する4つの要素と、業務の具体例で追う動作の流れを中心に解説します。
読み終える頃には、AIエージェントの仕組みを社内で説明でき、どの業務を任せるべきかを判断できるようになります。
目次
AIエージェントの仕組みはLLMを中心にした制御ループ
AIエージェントは、LLMが次の行動を決め、ツールで実行し、結果を見て再び判断する制御ループで動きます。まずは全体像と、各社の解説に共通する構造を確認しましょう。
AIエージェントは目標から手順を自分で組み立てる
AIエージェントは、人が手順を細かく指示しなくても、目標を渡すだけで作業の手順を自分で組み立てます。
中心にいるLLMが、目標と現在の状況を読み取り、次に何をすべきかを毎回判断しているためです。判断した行動はツールで実行され、その結果が再びLLMに渡されます。
たとえば「来週の会議資料を準備して」と頼むと、関連ファイルの検索、要点の整理、資料の作成という順番をAIエージェント自身が決めます。ファイルが見つからなければ、別の場所を探す軌道修正も行います。
Anthropicも、エージェントを「LLMが自らの処理の流れとツールの使い方を動的に決めるシステム」と定義しています。
出典:『Building effective agents』(Anthropic)
手順ではなく目標で指示できる点を押さえると、AIエージェントに任せる業務の切り出し方が見えてきます。
主要各社の解説も同じ構造に行き着く
AIエージェントの構成要素は解説によって呼び方が異なりますが、中身はほぼ同じ部品に整理できます。
どの解説も「判断する部品」「振る舞いを決める部品」「外部に働きかける部品」「記憶する部品」を、別の言葉で説明しているためです。
| 出典 | 判断する部品 | 振る舞いを決める部品 | 外部に働きかける部品 | 記憶する部品 |
|---|---|---|---|---|
| Anthropic | LLM | 記載なし | ツール・検索 | メモリ |
| OpenAI Agents SDK | モデル | 指示 | ツール | 基本設定には含まれない |
| Wangらのサーベイ論文 | 計画 | プロファイル | 行動 | メモリ |
出典:『Building effective agents』(Anthropic)
出典:『Agents』(OpenAI Agents SDK)
出典:『A Survey on Large Language Model based Autonomous Agents』(arXiv)
本記事では、この共通部分を「LLM・指示・ツール・メモリ」の4要素として解説します。名称が違う資料を読むときも、どの部品の話かを対応づけられるようになります。
AIエージェントを構成する4つの要素
AIエージェントは、以下の4つの要素の組み合わせで動いています。
- LLM:状況を読み取り次の行動を決める頭脳
- 指示:役割とルールを定める設計図
- ツール:検索やシステム操作を担う手足
- メモリ:経緯と知識を保持する記憶
どれか1つが欠けても、AIエージェントは目標どおりに動けません。
LLM:状況を読み取り次の行動を決める頭脳
LLM(大規模言語モデル)は、AIエージェントの中で次に何をするかを決める判断役です。
LLMは文章を理解し生成する能力を持つため、目標・指示・これまでの結果をまとめて読み取り、次の一手を出力できます。OpenAIのGPTシリーズ、AnthropicのClaude、GoogleのGeminiが代表例です。
ただし、LLM自体は文章を出力するだけで、メール送信やファイル保存などの操作は行えません。操作は後述のツールが担い、LLMは「どのツールを、どの値で使うか」を指示します。
判断の質はLLMの性能に左右されます。ベンダーの提案を比較するときは、どのLLMを採用しているかを確認すると違いを把握しやすくなります。
指示:役割とルールを定める設計図
指示は、AIエージェントの役割・守るべきルール・完了の条件を定める設定です。システムプロンプトとも呼ばれます。
同じLLMでも、指示が曖昧だと判断がぶれ、不要な操作をしたり途中で止まったりします。OpenAIのAgents SDKでも、指示の設定は「強く推奨」とされています。
出典:『Agents』(OpenAI Agents SDK)
指示には、以下のような内容を書きます。
- 役割:「あなたは経理部の請求書処理担当です」
- ルール:「10万円を超える支払いは処理せず、担当者に確認する」
- 完了条件:「全件を会計システムに登録したら終了する」
現場のルールを指示に落とし込むほど判断が安定します。AIエージェントの品質は、業務を知る担当者がどれだけ関わるかで大きく変わります。
ツール:検索やシステム操作を担う手足
ツールは、AIエージェントが外部の情報を取りに行ったり、システムを操作したりするための機能です。
LLMは学習時点までの知識しか持たず、外部のシステムにも直接触れられません。ツールを持たせることで、最新情報の検索や社内システムへの登録といった実務が可能になります。
代表的なツールは以下のとおりです。
- Web検索
- 社内文書の検索
- メールやビジネスチャットの送信
- 表計算ソフトや会計システムへの入力
- プログラムの実行
どのツールを持たせるかが、そのAIエージェントにできることの範囲を決めます。導入時は「何をさせたいか」から逆算してツールを選ぶと、過不足のない構成にできます。
メモリ:経緯と知識を保持する記憶
メモリは、作業の経緯や業務の知識をAIエージェントに保持させる仕組みです。
LLMは呼び出されるたびに過去のやり取りを忘れます。外部に記憶を持たせないと、同じ検索を繰り返したり、前の結果と矛盾したりします。
Wangらのサーベイ論文では、メモリを以下の2種類に整理しています。
- 短期メモリ:今回の作業の経緯で、LLMが一度に読み込める範囲に保持する
- 長期メモリ:過去の作業記録や知識で、外部のデータベースに保存し必要なときに検索する
出典:『A Survey on Large Language Model based Autonomous Agents』(arXiv)
長期メモリに社内マニュアルや過去の対応履歴を入れておくと、自社のやり方に沿った判断をさせやすくなります。
AIエージェントが動く流れは5ステップ
AIエージェントは、目標を受け取ってから終了するまで、以下の5ステップで動きます。
- 目標を受け取って理解する
- タスクを分解して計画を立てる
- ツールを選んで実行する
- 結果を確かめて次の行動を決める
- 完了条件を満たしたら終了する
ステップ3と4を何周も繰り返す点こそ、AIエージェントが自律的に見える理由です。
目標を受け取って理解する
最初のステップでは、AIエージェントが人から渡された目標と指示を読み取ります。
目標が曖昧なまま動き出すと、途中の判断がすべてずれるためです。Anthropicも、エージェントは人の指示や対話でタスクを明確にしてから動き出すと説明しています。
出典:『Building effective agents』(Anthropic)
たとえば「競合の料金を調べて」という依頼だけでは、対象の企業や比較する項目が決まりません。AIエージェントによっては、不足している条件を人に質問してから作業を始めます。
依頼する側が目標・対象・期限・成果物の形を最初に伝えておくと、やり直しの少ない動きを引き出せます。
タスクを分解して計画を立てる
次に、AIエージェントは目標を実行できる単位の小さなタスクに分解し、取り組む順番を決めます。
「比較表を作る」という目標は、1回の操作では完了できないためです。Wangらの論文でも、計画は複雑なタスクを小さなタスクに分ける役割と位置づけられています。
料金比較の場合は、以下の4つのタスクに分けます。
- 各社の料金ページを探す
- プランと金額を抜き出す
- 表にまとめる
- 関係者に共有する
計画は最初に決めて終わりではなく、作業の結果に応じて組み直されます。計画の段階を知っておくと、AIエージェントの作業記録から意図を追いやすくなります。
ツールを選んで実行する
計画が決まると、AIエージェントはタスクに合ったツールを選び、必要な値を指定して実行します。
LLMは「Web検索ツールを、検索語『A社 料金プラン』で使う」といった指示を出力します。実際にツールを動かすのは、AIエージェントの実行環境です。
OpenAIの開発者向け解説でも、モデルがツールの呼び出しを返し、アプリケーション側がコードを実行する流れが示されています。
出典:『Function calling』(OpenAI)
判断と実行が分かれているため、実行環境側で「この操作は禁止」と制限をかけられます。安全対策を考えるうえで重要な構造です。
結果を確かめて次の行動を決める
ツールの実行結果は再びLLMに渡され、AIエージェントは結果を見て次の行動を判断します。
結果を確かめずに進むと、検索に失敗したまま空の表を作るといった誤りが起きます。Anthropicは、各ステップで実際の実行結果から進み具合を確かめることが重要だとしています。
料金ページが見つからなければ検索語を変えて再検索し、金額が税抜表示なら税込に換算するといった判断を、結果を見ながら行います。
このステップがあるため、AIエージェントは想定外の状況にも対応できます。決まった手順しか実行できない従来の自動化ツールとの大きな違いもこの点です。
完了条件を満たしたら終了する
AIエージェントは、指示で定めた完了条件を満たした時点でループを終えます。
終了の基準がないと、AIエージェントは作業を続けたり、同じ処理を繰り返したりします。そのため、多くの開発基盤には処理回数の上限も用意されています。
OpenAIのAgents SDKでは、ツールを呼ばずに最終的な回答を出した時点でループが終わります。設定した最大回数(max_turns)を超えた場合も処理を止めます。
出典:『Running agents』(OpenAI Agents SDK)
完了条件と回数の上限を両方決めておくと、時間や費用が想定外に膨らむ事態を防げます。
業務の具体例で見るAIエージェントの仕組み
ここまでの5ステップを、「競合3社の料金プランを調べ、比較表にしてSlackで共有する」という業務に当てはめて確認します。通常の流れと、エラーが起きたときの動きの2つを見ていきましょう。
競合調査レポートを作るまでの思考と行動
この業務では、AIエージェントが「考える→行動する→結果を確かめる」を何周も繰り返して完了させます。
1回の検索や書き込みでは終わらず、結果を見ながら次の作業を決める必要があるためです。各周の動きは以下のとおりです。
| 周 | 考えたこと | 行動 | 結果 |
|---|---|---|---|
| 1 | まずA社の料金ページを探す | 「A社 料金プラン」でWeb検索する | 料金ページのURLを取得 |
| 2 | ページからプランと金額を抜き出す | 料金ページを読み込む | プラン名と月額を取得 |
| 3 | B社とC社も同じ手順で調べる | 検索と読み込みを繰り返す | 3社分の料金がそろう |
| 4 | 比較しやすい表にまとめる | 表計算ソフトに書き込む | 比較表が完成 |
| 5 | 完了条件の「共有」を満たす | Slackに投稿する | 投稿を確認して終了 |
人が行ったのは最初の依頼だけで、ツールの選択や作業の順番はAIエージェントが判断しています。
自社の業務も同じように「周」に分けて書き出すと、AIエージェントに任せられる範囲を具体的に見積もれます。
途中でエラーが起きたときの立て直し方
作業中に想定外の結果が返ってきても、AIエージェントは結果を読み取って別の手段を試します。
毎回結果を確認しているため、失敗も次の判断材料として扱えるからです。B社の料金ページに金額が載っていなかった場合、AIエージェントは以下のように動きます。
- プレスリリースや製品資料で金額を再検索する
- それでも見つからなければ、表に「非公開」と記載する
- 報告時に「B社は金額非公開のため要確認」と人に伝える
ただし、立て直しの判断が常に正しいとは限りません。古い情報源の金額を採用するおそれもあるため、重要な数字は人が最終確認する運用が欠かせません。
「失敗したら人に報告する」と指示に書いておくと、AIエージェントが無理に作業を進めるリスクを減らせます。
AIエージェントと生成AIの違いは仕組みにある
AIエージェントと生成AI・チャットボットの違いは、結果を見て行動を続けるループを持つかどうかです。3つの仕組みは以下のように異なります。
- 生成AIは1回の応答で処理が終わる
- チャットボットは決められたシナリオで応答する
- AIエージェントは結果を見て行動を続ける
違いを仕組みで理解しておくと、業務ごとにどれを使うべきかを判断しやすくなります。
生成AIは1回の応答で処理が終わる
生成AIは、指示に対して1回応答を返した時点で処理が終わります。
生成AIの中核であるLLMは、入力された文章に対して出力を返す仕組みで、自分から次の行動を起こしません。結果の確認や次の指示は、すべて人が担います。
たとえばChatGPTに「取引先へのお礼メールを書いて」と頼めば文面は返ってきます。しかし、送信や返信の確認は人が行う必要があります。
生成AIは「考える」部分を担う部品であり、AIエージェントは生成AIにツールとループを加えた仕組みと捉えると、両者の関係を整理できます。
チャットボットは決められたシナリオで応答する
従来型のチャットボットは、あらかじめ設計されたシナリオに沿って応答します。
質問と回答の組み合わせや分岐を人が事前に作っているためです。想定外の質問には「担当者におつなぎします」といった定型の応答しか返せません。
最近はLLMを組み込んだチャットボットも増えています。それでも、会話の中で回答を返すことが主な役割である点は変わりません。
問い合わせ対応を自動化する場合も、回答だけで済むのか、システム操作まで必要なのかで、チャットボットとAIエージェントのどちらが合うかが決まります。
AIエージェントは結果を見て行動を続ける
AIエージェントは、行動の結果を見て次の行動を決め、目標を達成するまで動き続けます。
LLMの判断にツールとメモリ、制御ループを組み合わせているため、回答を返すだけでなく操作と確認を繰り返せます。3つの仕組みの違いを表にまとめました。
| 比較項目 | 生成AI | チャットボット | AIエージェント |
|---|---|---|---|
| 動き方 | 1回応答して終わる | シナリオに沿って応答する | 目標達成まで行動を続ける |
| 外部の操作 | 基本的に行わない | 基本的に行わない | ツールで検索や登録を行う |
| 想定外への対応 | 人が次の指示を出す | 定型の応答を返す | 結果を見て別の手段を試す |
| 人の役割 | 毎回指示と確認をする | シナリオを設計する | 目標を渡し結果を確認する |
人が毎回指示を出さなくても、複数の手順にまたがる業務を一続きで進められる点が、AIエージェントならではの価値です。
AIエージェントの仕組みを支える4つの技術
AIエージェントの仕組みは、以下の4つの技術で支えられています。
- ReAct:思考と行動を交互に繰り返す手法
- Function Calling:LLMがツールの呼び出しを指示する機能
- RAG:社内文書を検索して判断の根拠にする手法
- MCP:外部ツールとの接続をそろえる標準規格
ベンダーの資料に出てくる技術用語の多くは、この4つのいずれかに当てはまります。
ReAct:思考と行動を交互に繰り返す手法
ReAct(リアクト)は、LLMに「思考」と「行動」を交互に出力させる手法で、AIエージェントのループの原型です。
2022年にプリンストン大学とGoogleの研究者が発表しました。考えた内容を書き出しながら行動することで、計画の修正や例外への対応がしやすくなると示されています。
出典:『ReAct: Synergizing Reasoning and Acting in Language Models』(arXiv)
ReActでは、以下の3つを1組として繰り返します。
- 思考(Thought):次に何をすべきかを考える
- 行動(Action):ツールを使って実行する
- 観察(Observation):実行結果を読み取る
先ほどの具体例で示した「考えたこと・行動・結果」の表も、この3つに対応しています。ReActを知っておくと、AIエージェントの作業記録を読み解きやすくなります。
Function Calling:LLMがツールの呼び出しを指示する機能
Function Calling(ファンクションコーリング)は、LLMが「どのツールをどの値で使うか」を決まった形式で出力する機能です。
LLMの出力は本来ただの文章のため、プログラムがそのまま実行するのは困難です。ツールの名前と値をJSONという決まった形式で返させることで、実行環境が確実にツールを動かせます。
OpenAIの解説では、以下の流れが示されています。
- 使えるツールの一覧を付けてモデルに依頼する
- モデルからツールの呼び出し内容を受け取る
- アプリケーション側でツールを実行する
- 実行結果を付けて、モデルに再度依頼する
- モデルから最終的な回答か、追加の呼び出しを受け取る
LLMは判断だけを担い、実際の操作はアプリケーション側で管理できます。権限の制御もアプリケーション側で行えるため、業務システムとつなぐ際の安全性に直結する技術です。
RAG:社内文書を検索して判断の根拠にする手法
RAG(検索拡張生成)は、外部の文書を検索し、その内容を根拠にLLMに回答させる手法です。
LLMは、学習していない社内規程や最新の情報を知りません。必要な文書を検索してLLMに渡すことで、知識の不足を補えます。2020年にLewisらが論文で提案した手法です。
出典:『Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks』(arXiv)
AIエージェントでは、RAGが長期メモリやツールの1つとして使われます。「経費規程を確認してから申請内容をチェックする」といった動きは、RAGで規程を検索して実現します。
社内文書が整理されているほど、RAGの精度は上がります。文書の整備は、AIエージェント導入前の準備としても効果があります。
MCP:外部ツールとの接続をそろえる標準規格
MCP(Model Context Protocol)は、AIと外部のデータやツールをつなぐ方法をそろえる標準規格です。2024年11月にAnthropicが公開しました。
出典:『Introducing the Model Context Protocol』(Anthropic)
以前は、AIエージェントにツールを1つ追加するたびに、個別の接続プログラムを開発する必要がありました。MCPに対応したツールであれば、共通の方式で接続できます。
Anthropicは、接続先の例としてコンテンツの保管庫、業務ツール、開発環境を挙げています。こうしたサービスがMCPの接続口を用意していれば、AIエージェントから同じ手順で呼び出せます。
ツールを選ぶ際にMCP対応の有無を確認しておくと、将来AIエージェントを入れ替えたり、つなぐツールを増やしたりする手間を減らせます。
AIエージェントの構成パターンは3つ
AIエージェントの仕組みを使ったシステムは、LLMにどこまで判断を任せるかで以下の3つに分けられます。
- ワークフロー型:決められた手順をLLMがこなす
- 単一エージェント型:1つのエージェントが手順を判断する
- マルチエージェント型:複数のエージェントが役割を分担する
業務の性質に合わない構成を選ぶと、費用がかさんだり動きが不安定になったりします。
ワークフロー型:決められた手順をLLMがこなす
ワークフロー型は、処理の順番を人が事前に決め、各工程の作業だけをLLMに任せる構成です。
Anthropicは、LLMとツールを事前に定めた手順で動かすシステムを「ワークフロー」と呼び、エージェントと区別しています。手順が固定されているため、動きを予測しやすいのが特徴です。
出典:『Building effective agents』(Anthropic)
「問い合わせメールを受信する→LLMが内容を分類する→分類ごとの担当者に転送する」のように、流れが毎回同じ業務に向いています。
手順を決められる業務であれば、まずワークフロー型から始めると、安定性と費用の両面で失敗しにくくなります。
単一エージェント型:1つのエージェントが手順を判断する
単一エージェント型は、1つのAIエージェントが手順そのものを判断しながら作業を進める構成です。
本記事で解説してきた制御ループは、この構成を前提にしています。手順を事前に決められない業務に対応できる一方、動きの予測はワークフロー型より難しくなります。
調査やデータ整理のように、状況に応じて調べ方や進め方を変える必要がある業務に向いています。前述の競合料金の調査も、この構成の代表例です。
判断の自由度が高い分、権限の範囲や停止条件の設計がより重要になります。
マルチエージェント型:複数のエージェントが役割を分担する
マルチエージェント型は、役割の異なる複数のAIエージェントが分担して1つの業務を進める構成です。
1つのエージェントに多くのツールや役割を持たせると、判断が混乱しやすくなるためです。統括役のエージェントが、ほかのエージェントに作業を振り分ける形が代表的です。
たとえば「調査担当」「執筆担当」「チェック担当」の3つのエージェントで、1本のレポートを仕上げるといった使い方があります。
ただし、構成が複雑になり、処理時間と費用も増えます。単一エージェントで対応できない場合に検討する順番で考えると、無駄な投資を避けられます。
AIエージェントの仕組みから見える4つの限界
仕組みを理解すると、AIエージェントが苦手とする点も見えてきます。主な限界は以下の4つです。
- 誤った判断がループの中で積み重なる
- 一度に扱える情報量に上限がある
- 権限が広いほど誤操作の影響が大きくなる
- 処理の回数に比例して時間と費用が増える
いずれも仕組みに由来するため、ツールを変えるだけでは解消できません。
誤った判断がループの中で積み重なる
AIエージェントには、1回の誤った判断が後の工程に引き継がれやすいという弱点があります。
各周の判断は、前の周の結果を前提にしているためです。LLMはもっともらしい誤り(ハルシネーション)を出力することもあり、その誤りを土台に作業を進めてしまいます。
料金調査で古い価格ページを読み込むと、比較表から分析、共有文まで、すべてが古い価格をもとに作られます。
誤りの連鎖を防ぐには、重要な工程の途中で人やチェック処理が結果を確認する仕組みが必要です。
一度に扱える情報量に上限がある
LLMには、一度に読み込める情報量(コンテキストウィンドウ)に上限があります。
作業が長くなるほど、経緯やツールの結果が積み重なり、上限に近づきます。Wangらの論文でも、短期メモリはコンテキストの長さに制限され、情報量が多いと性能が落ちる場合があると指摘されています。
大量の書類を1回の作業でまとめて処理させると、前半の内容を見落としたり、指示を守らなくなったりすることがあります。
大きな業務は小さく区切って依頼し、必要な情報は長期メモリから取り出す設計にすると、上限の影響を抑えられます。
権限が広いほど誤操作の影響が大きくなる
AIエージェントは、持たせたツールの権限の範囲で、実際にシステムを操作します。
生成AIの誤りは文章の誤りで済みます。一方、AIエージェントの誤りはメールの誤送信やデータの削除といった実害につながります。
顧客データベースの更新権限を持たせた場合、判断を誤れば多くの顧客情報を誤ったデータで上書きするおそれがあります。外部のWebページに仕込まれた悪意ある指示を読み込み、意図しない操作をしてしまう危険もあります。
権限は「できると便利か」ではなく、「その業務に必要か」で決めることが、被害を小さくする前提です。
処理の回数に比例して時間と費用が増える
AIエージェントは、ループを回るたびにLLMを呼び出すため、時間と費用が増えます。
LLMの利用料金は、一般に処理した文字量(トークン)に応じて決まります。1周ごとにそれまでの経緯も含めて読み込むため、周回が増えるほど処理量が膨らみます。
1回の質問で済む作業をAIエージェントに任せると、検索や確認を挟む分、生成AIに直接聞くより時間も費用もかかります。
費用対効果を見積もる際は、1件あたりの処理回数を試験運用で計測し、人が作業した場合の費用と比べると判断しやすくなります。
AIエージェントを安全に動かすための仕組み
前述の4つの限界は、以下の4つの仕組みを組み合わせることで抑えられます。
- ガードレールで入力と出力を検査する
- ツールの権限を業務に必要な範囲に絞る
- 重要な操作の前に人の承認を挟む
- 停止条件と実行ログを設定する
ベンダーやサービスを選ぶ際も、これらの仕組みが用意されているかが判断材料になります。
ガードレールで入力と出力を検査する
ガードレールは、AIエージェントへの入力と、AIエージェントの出力を自動で検査する仕組みです。
問題のある依頼や不適切な出力を、処理の前後で止められます。OpenAIのAgents SDKにも、入力を検査する仕組みと、最終出力を検査する仕組みが用意されています。
出典:『Guardrails』(OpenAI Agents SDK)
個人情報を含む依頼を受け付けない、社外に出す文章に機密情報が含まれていないかを確かめる、といった検査を設定できます。
検査を仕組みとして組み込むと、利用者一人ひとりの注意に頼らずに一定の安全性を保てます。
ツールの権限を業務に必要な範囲に絞る
AIエージェントに持たせる権限は、業務に必要な最小限の範囲に絞ります。
前述のとおり判断と実行は分かれており、実行環境側で操作を制限できます。権限を絞っておけば、判断を誤っても被害の範囲が限られます。権限の絞り方の例は以下のとおりです。
- 閲覧だけで済む業務には、書き込み権限を与えない
- 送信先を社内のアドレスやチャンネルに限定する
- 削除や支払いなど取り消せない操作は、ツールとして持たせない
最初は狭い権限で始め、運用実績を見ながら広げる進め方が安全です。
重要な操作の前に人の承認を挟む
取り消しの難しい操作の前には、AIエージェントを一時停止させ、人の承認を挟む設計にします。
Anthropicも、エージェントはチェックポイントや行き詰まった場面で一時停止し、人の判断を仰げると説明しています。
出典:『Building effective agents』(Anthropic)
ChatGPTのエージェント機能も、発表時点で重要な操作の前に利用者の許可を求める仕様でした。
出典:『Introducing ChatGPT agent』(OpenAI)
AIが作業し、人が承認するという役割分担にすると、最終的な責任の所在も明確になります。
停止条件と実行ログを設定する
AIエージェントには、止まる条件と、何をしたかを後から追える記録を必ず設定します。
停止条件がないと、エラーのたびに再試行を続けて費用がかさみます。Anthropicも、制御を保つために最大反復回数などの停止条件を設けるのが一般的だとしています。停止条件の例は以下のとおりです。
- 完了条件を満たしたら終了する
- 処理回数が上限に達したら終了する
- 同じエラーが続いたら人に報告して停止する
実行ログにLLMの判断とツールの実行結果を残しておくと、問題が起きた際に原因を特定し、指示や権限を改善できます。
仕組みから判断するAIエージェントに任せやすい業務
仕組みと限界を踏まえると、AIエージェントに任せやすい業務と、人の判断を残すべき業務を区別できます。自社の業務を当てはめながら確認しましょう。
任せやすい業務に共通する4つの条件
AIエージェントに任せやすいのは、以下の4つの条件を満たす業務です。
- 目標と完了条件を言葉で定義できる
- 必要な情報やシステムにツールで接続できる
- 結果の正しさを確認する方法がある
- 誤りがあっても取り消しや修正ができる
4つの条件は、それぞれ「指示」「ツール」「結果の確認」「権限」という仕組みの要素に対応しています。条件を満たすほど、AIエージェントのループが安定して回ります。
競合情報の収集、問い合わせの一次分類、会議日程の調整、社内文書の検索と要約などは、条件を満たしやすい業務です。
自社の業務をこの4つの条件で点検すると、試験導入の候補を短時間で絞り込めます。
人の判断を残すべき業務の特徴
一方で、誤りの影響が大きく、取り消しが難しい業務には人の判断を残すべきです。
誤った判断がループで積み重なる性質と、権限の範囲で実際に操作する性質を考えると、最終判断までAIに任せるのは危険です。該当する業務の例は以下のとおりです。
- 支払いや契約の締結など、金銭や法的責任を伴う業務
- 採用の合否や人事評価など、人の処遇を決める業務
- 顧客や社外への正式な回答・発表
これらの業務でも、情報収集や下書きはAIエージェントに任せられます。最終判断だけを人が担う分担にすると、安全性を保ちながら作業時間を減らせます。
AIエージェントの仕組みに関するよくある質問
AIエージェントの仕組みに関する質問は以下の4つです。
- ChatGPTはAIエージェントですか?
- AIエージェントは使うほど学習して賢くなりますか?
- AIエージェントを使うのにプログラミングは必要ですか?
- 使うLLMが変わるとAIエージェントの動きも変わりますか?
質問に対する回答を確認して、AIエージェントの導入を検討する際の参考にしてみてください。
ChatGPTはAIエージェントですか?
ChatGPTは、使い方によって生成AIにもAIエージェントにもなります。
通常のチャットで質問に回答を返す使い方は、生成AIとしての利用です。一方、2025年7月にはエージェント機能「ChatGPT agent」が追加されました。
ChatGPT agentは、ブラウザやターミナルなどのツールを使い分けながら、利用者に代わって作業を進めます。目標を受け取り、ツールで行動し、結果を確かめる構造は、本記事で解説した仕組みそのものです。
出典:『Introducing ChatGPT agent』(OpenAI)
普段使っているサービスがどちらの使い方なのかを見分けられると、社内で説明する際にも混乱を防げます。
AIエージェントは使うほど学習して賢くなりますか?
一般的なAIエージェントでは、使うだけでLLM自体が再学習されることはありません。
構成要素に「学習」を含める解説もあります。ただし、実務で使われるAIエージェントの多くは、作業記録や修正内容をメモリに保存し、次の判断で参照する形で改善します。
精度を上げたい場合は、指示の見直しや、メモリに入れる情報の追加で対応するのが一般的です。
なお、利用データがLLMの学習に使われるかどうかはサービスごとに規約が異なります。導入前に必ず確認しましょう。
AIエージェントを使うのにプログラミングは必要ですか?
既製のサービスやノーコードの開発ツールを使う場合、プログラミングは必要ありません。
ChatGPT agentのように、チャット画面で目標を伝えるだけで使えるサービスがあります。Microsoft Copilot StudioやDify(ディファイ)など、画面操作でエージェントを作れるツールもあります。
一方、自社システムと深く連携させる場合や、権限とログを細かく設計する場合は、開発の知識が必要です。
まずは既製のサービスで仕組みを体感し、業務への適用範囲が見えてから開発を検討すると、無駄な投資を避けられます。
使うLLMが変わるとAIエージェントの動きも変わりますか?
判断を担うLLMが変わると、計画の立て方やツールの選び方も変わります。
同じ指示を与えても、LLMによって指示の解釈や守り方に差が出るためです。あるLLMでは守れていたルールが、別のLLMでは守られないこともあります。
LLMを切り替える際は、同じ業務で試験的に動かし、結果を比較してから本番に移すのが安全です。
MCPのような標準規格に対応したツールを使っておくと、LLMを切り替えてもツール側の作り直しを減らせます。
AIエージェントは部品と制御ループで理解すると導入判断がしやすい
AIエージェントの仕組みは、LLM・指示・ツール・メモリの4つの要素を、「考える→行動する→結果を確かめる」の制御ループで回す構造です。生成AIとの違いも、結果を見て行動を続けるこのループにあります。
一方で、誤りの積み重なりや権限による実害など、仕組みに由来する限界もあります。ガードレール、権限の制限、人の承認、停止条件を組み合わせれば、安全に動かせます。
まずは自社の業務を1つ選び、「任せやすい業務の4つの条件」に当てはめてみましょう。条件を満たす業務が見つかれば、それが試験導入の第一候補です。
次に考えるべきは、その業務にどのサービスや開発基盤を使うかです。仕組みを理解した今なら、ベンダーの提案を「どのLLMを使い、どのツールに、どこまでの権限でつなぐのか」という観点で比較できます。